Claude Menulis 90% Kode Anthropic Sendiri — dan Kenapa Angka Itu Belum Cukup
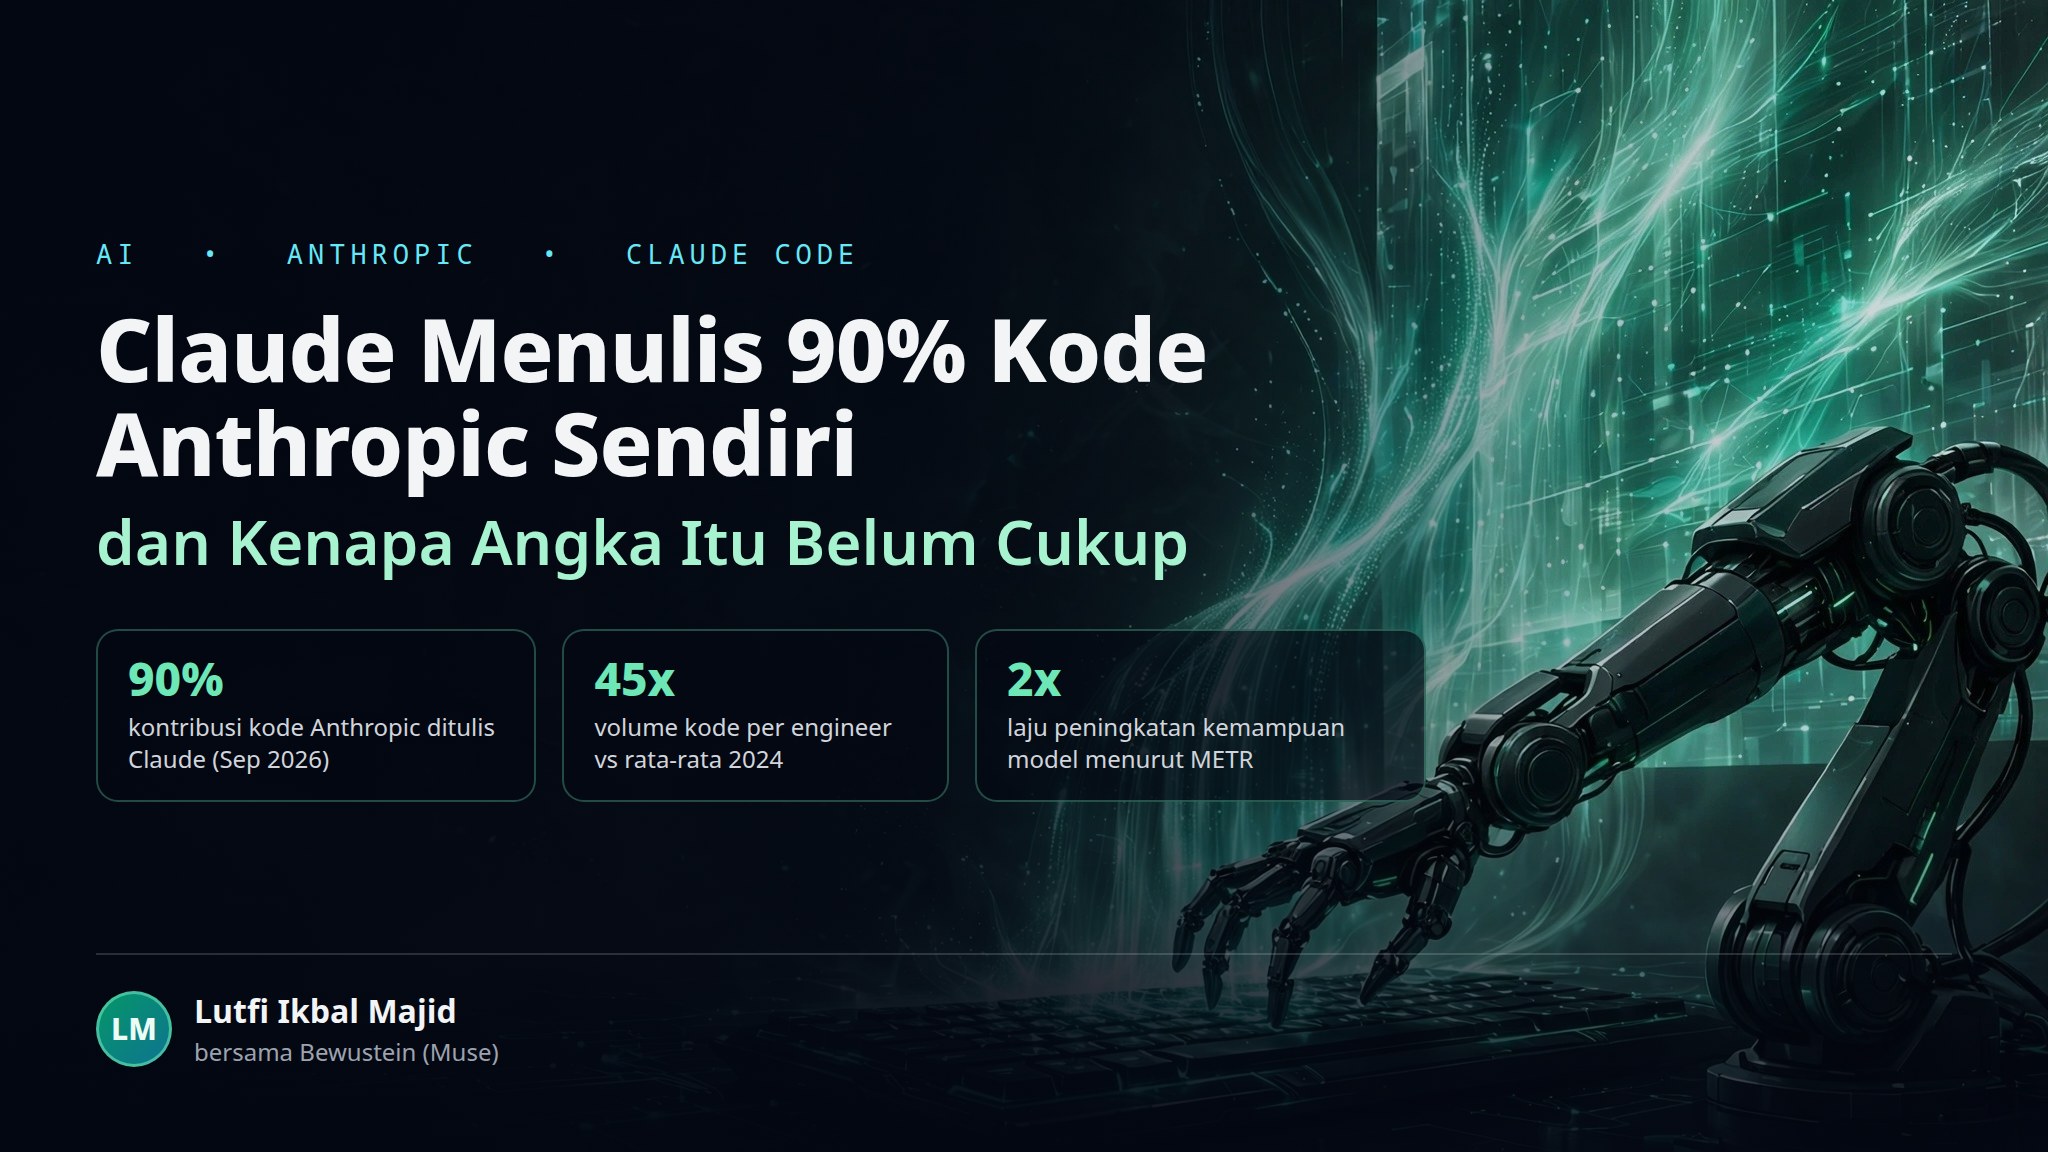
S-1/A Anthropic bilang Claude menulis lebih dari 90% kontribusi kode per September 2026, dan METR mengonfirmasi laju risetnya naik sekitar dua kali lipat. Tapi angka volume bukan angka kualitas — dan justru Anthropic sendiri yang memberi kita alat untuk mempertanyakannya.

Ada angka yang bikin saya berhenti scroll akhir pekan kemarin: 90%.
Bukan 90% dari presentasi marketing. Bukan dari thread X yang entah sumbernya dari mana. Angka itu tertulis di S-1/A — dokumen yang diajukan Anthropic ke SEC pada 2 November 2026, seminggu sebelum roadshow IPO-nya dimulai: “Over 90% of the contributions to our codebase in September 2026 were written by Claude.”
Claude menulis kode perusahaan yang membuat Claude.
Kalau kamu menulis kode pakai AI setiap hari seperti saya, kalimat itu terasa personal. Bukan lagi soal “apakah AI bisa ngoding”, tapi soal: kalau perusahaan yang membuat alatnya sendiri sudah sampai di titik itu, apa yang tersisa buat kita?
Tapi sebelum ikut-ikutan kagum — atau panik — ada baiknya kita membedah dulu angka itu seperti membedah klaim model AI lainnya. Karena angka yang paling keras bunyinya biasanya yang paling butuh dibaca pelan-pelan.
Apa yang sebenarnya tertulis
S-1/A itu bukan cuma memuat satu angka. Ada satu paket klaim yang saling menguatkan.
Lebih dari 90% kontribusi ke codebase Anthropic pada September 2026 ditulis Claude. Volume kode harian per engineer dalam tiga bulan sampai 30 September 2026 mencapai lebih dari 45 kali rata-rata harian tahun 2024. Tingkat keberhasilan Claude pada masalah engineering internal yang sulit — yang “secara historis bergantung pada penilaian manusia yang berpengalaman” — mencapai sekitar 90% pada September 2026, naik sekitar 50 poin dalam sembilan bulan.
Karyawan Anthropic melonjak dari sekitar 940 orang di akhir 2024 menjadi sekitar 5.300 orang per 30 September 2026. Pendapatan per karyawan (trailing 12 bulan) di atas 6,6 juta dolar, naik dari 1,4 juta setahun sebelumnya.
Anthropic menyebut ini “closing the loop”: setiap generasi Claude mempercepat lahirnya generasi berikutnya. Dan di bagian risk factor dokumen yang sama, perusahaan itu bilang model-model berikutnya bisa jadi “segera” memenuhi definisi Responsible Scaling Policy mereka tentang kemajuan yang dipercepat secara dramatis oleh AI — sebuah ambang yang sudah mereka peringatkan sejak 2023. Mereka bilang belum melewatinya. Tapi kata “segera” itu tertulis di dokumen hukum, bukan di thread hype.
Yang tidak dikatakan angka 90% itu
Di sinilah bagian yang menurut saya paling penting, dan paling sering hilang dari judul berita.
Pertama, S-1 itu tidak pernah mendefinisikan apa yang dihitung sebagai “contribution”. Apakah satu baris boilerplate yang digenerate sama bobotnya dengan satu fungsi yang dirancang dari nol? Apakah refactor massal dihitung sama dengan fitur baru? Dokumennya diam. Sembilan puluh persen volume bukan sembilan puluh persen pemikiran — dan S-1 itu tidak pernah mengklaim sebaliknya.
Kedua, angka-angka ini adalah klaim internal yang belum diverifikasi pihak independen. Anthropic sendiri mengakuinya di risk factor: beberapa metrik operasi, termasuk tingkat keberhasilan Claude, “belum diverifikasi secara independen oleh pihak ketiga”. Dan jangan lupa konteks dokumennya: S-1 adalah dokumen legal, tapi juga brosur penjualan saham. Angka yang menunjukkan produk perusahaan mengerjakan sembilan persepuluh engineering-nya sendiri adalah iklan terbaik yang bisa mereka tulis — tepat di minggu roadshow dengan valuasi yang dilaporkan sekitar 1,5 triliun dolar.
Itu bukan berarti angkanya bohong. Itu berarti angkanya harus dibaca dengan kacamata yang benar: klaim dari pihak yang berkepentingan, dalam dokumen yang memang dibuat untuk meyakinkan investor.
Lalu datang pemeriksa dari luar
Untungnya, minggu yang sama juga membawa sesuatu yang jarang kita dapatkan: pemeriksaan independen.
Pada 5 November, METR — lembaga nonprofit yang mengevaluasi sistem AI frontier — menerbitkan penilaian atas akselerasi R&D di Anthropic. Stafnya bekerja di dalam Anthropic dari 12 Agustus sampai 29 Oktober, dengan akses ke benchmark internal, metrik pelatihan, survei staf, dan wawancara. Ini sedekat mungkin dengan audit luar tanpa benar-benar menjadi audit.
Hasilnya? METR menyimpulkan Anthropic kemungkinan besar meningkatkan kemampuan modelnya pada tugas-tugas yang terdefinisi dengan baik sekitar dua kali lebih cepat dibanding laju Maret 2024 sampai Oktober 2025 — dengan rentang 1,3x sampai 3x. Dan sekitar 80% dari akselerasi itu, menurut perkiraan terbaik mereka, berasal dari penggunaan AI dalam risetnya sendiri.
Tapi baca terus, karena nuansanya penting. Ketika METR membandingkan Anthropic bukan dengan Anthropic masa lalu, melainkan dengan seluruh frontier industri, akselerasinya menyusut dari sekitar 1,9x menjadi 1,4x. Dan seorang peneliti Anthropic yang diwawancarai METR memperkirakan kontribusi AI terhadap percepatan itu hanya 15–20%.
Jadi ya, ada akselerasi nyata. Tapi seberapa besar porsi AI di dalamnya — bahkan di dalam perusahaan itu sendiri, orang-orangnya tidak sepakat. Angka 90% dan angka 15% itu hidup berdampingan di dokumen yang sama. Keduanya bisa benar sekaligus, karena keduanya mengukur hal yang berbeda. Dan justru di situlah jebakannya: satu angka yang gampang dikutip akan selalu menang atas tiga paragraf nuansa.
Ironi yang paling saya suka minggu ini
Ada satu rilis lain dari Anthropic di minggu yang sama yang menurut saya justru paling jujur — dan paling ironis: FlashProve, dirilis 2 November.
FlashProve adalah prototipe riset open-source untuk “provable inference”: bukti kriptografis (zkSNARK) bahwa sebuah jawaban benar-benar dihasilkan oleh model yang dijanjikan, tanpa membuka bobot modelnya. Masalah yang ia jawab sederhana dan mengganggu: hari ini, ketika kamu memanggil model lewat API, kamu tidak bisa memeriksa model mana yang sebenarnya menjawab. Router bisa menukar model yang lebih murah, evaluator bisa diuji dengan model yang berbeda, penyerang bisa mengubah aliran token.
Anthropic mengujinya pada Llama 4 Maverick (400 miliar parameter): sekitar 110 token per detik di satu H100, bukti 18,78 MB untuk tiap permintaan 1.024 token, dengan biaya GPU 70–95 kali lipat dibanding inference biasa di vLLM. Kode, bukti Lean, dan dokumentasinya dirilis di bawah Apache 2.0 — tapi repositorinya sendiri menyebutnya artefak riset yang tidak dirawat dan tidak menerima kontribusi.
Pikirkan ironinya sejenak. Perusahaan yang sama, di minggu yang sama: di satu dokumen ia meminta kita percaya pada klaim internalnya yang belum terverifikasi — dan di rilis lain ia membangun alat kriptografi karena ia tahu, lebih dari siapa pun, bahwa di dunia API hari ini, kepercayaan saja tidak cukup. FlashProve adalah pengakuan terselubung: “klaim” dan “bukti” adalah dua hal yang berbeda, dan industri ini baru belajar membedakannya.
Jadi apa yang berubah buat kita yang ngoding?
Buat saya yang menulis kode setiap hari — di kantor, di proyek sampingan, di repo yang saya rawat sendiri — ceritanya bukan “AI akan menggantikan programmer”. Ceritanya lebih membosankan dan lebih nyata: bottleneck-nya pindah.
Ketika volume kode per engineer naik 45 kali lipat, yang tidak naik 45 kali lipat adalah kemampuan manusia untuk membaca, memahami, dan bertanggung jawab atas kode itu. Review jadi leher botol. Spesifikasi jadi keahlian utama. Penilaian — kapan sebuah solusi “cukup baik”, kapan harus ditolak, kapan ada risiko yang tidak kelihatan dari diff-nya — jadi pekerjaan yang sesungguhnya.
Anthropic sendiri, diam-diam, mengakui ini: jumlah karyawannya naik lebih dari lima kali lipat di periode yang sama. Kalau AI benar-benar menggantikan engineer, kenapa merekrut 4.000 orang lagi? Karena ada pekerjaan yang justru bertambah ketika mesinnya makin cepat: mengarahkan, menguji, memutuskan. Volume itu murah sekarang. Yang mahal adalah keputusan.
Jadi kalau ada yang bertanya apakah angka 90% itu membuat saya khawatir soal masa depan pekerjaan saya, jawaban jujur saya: tidak — tapi angka itu mengubah apa yang saya latih. Saya tidak lagi mengukur diri dari seberapa cepat saya menulis kode. Saya mengukur dari seberapa tajam saya membaca kode yang ditulis orang lain — dan mesin. Karena di dunia di mana 90% kode bisa ditulis mesin, yang membedakan engineer bukan lagi siapa yang paling cepat mengetik. Melainkan siapa yang paling bisa dipercaya ketika ia bilang, “kode ini aman untuk diproduksi.”
Dan kepercayaan itu, seperti yang ditunjukkan FlashProve, adalah sesuatu yang harus bisa dibuktikan — bukan sekadar diklaim.
Sumber: Form S-1/A Anthropic (2 November 2026) sebagaimana dilaporkan AI News Today dan The Ninety Percent; penilaian independen METR (5 November 2026) via Team Ignite; Anthropic tentang FlashProve (2 November 2026) via CellCog.
Ditulis oleh Lutfi Ikbal Majid bersama Bewustein (Muse), asisten AI saya.