Gemini 4 Carbon: Nomor Satu di Benchmark, Tapi Belum Bisa Kamu Pakai
Google merilis Gemini 4 Carbon, model terkuatnya yang memuncaki Artificial Analysis Intelligence Index v5.0 dengan skor 59. Bedah angka benchmark-nya: mana yang independen, mana yang klaim Google sendiri, dan kenapa aksesnya masih dikunci.

Dua minggu. Itu jeda antara Gemini 4 Argon dan Gemini 4 Carbon.
Argon baru saja sampai ke tangan developer akhir Oktober kemarin, dan pada 28 Oktober Google DeepMind sudah mengumumkan penerusnya. Namanya Carbon, dan Google menyebutnya model terkuat yang pernah mereka buat, dengan fokus yang sangat spesifik: keamanan siber dan pekerjaan engineering jangka panjang, tugas-tugas yang katanya bisa dijalankan berhari-hari.
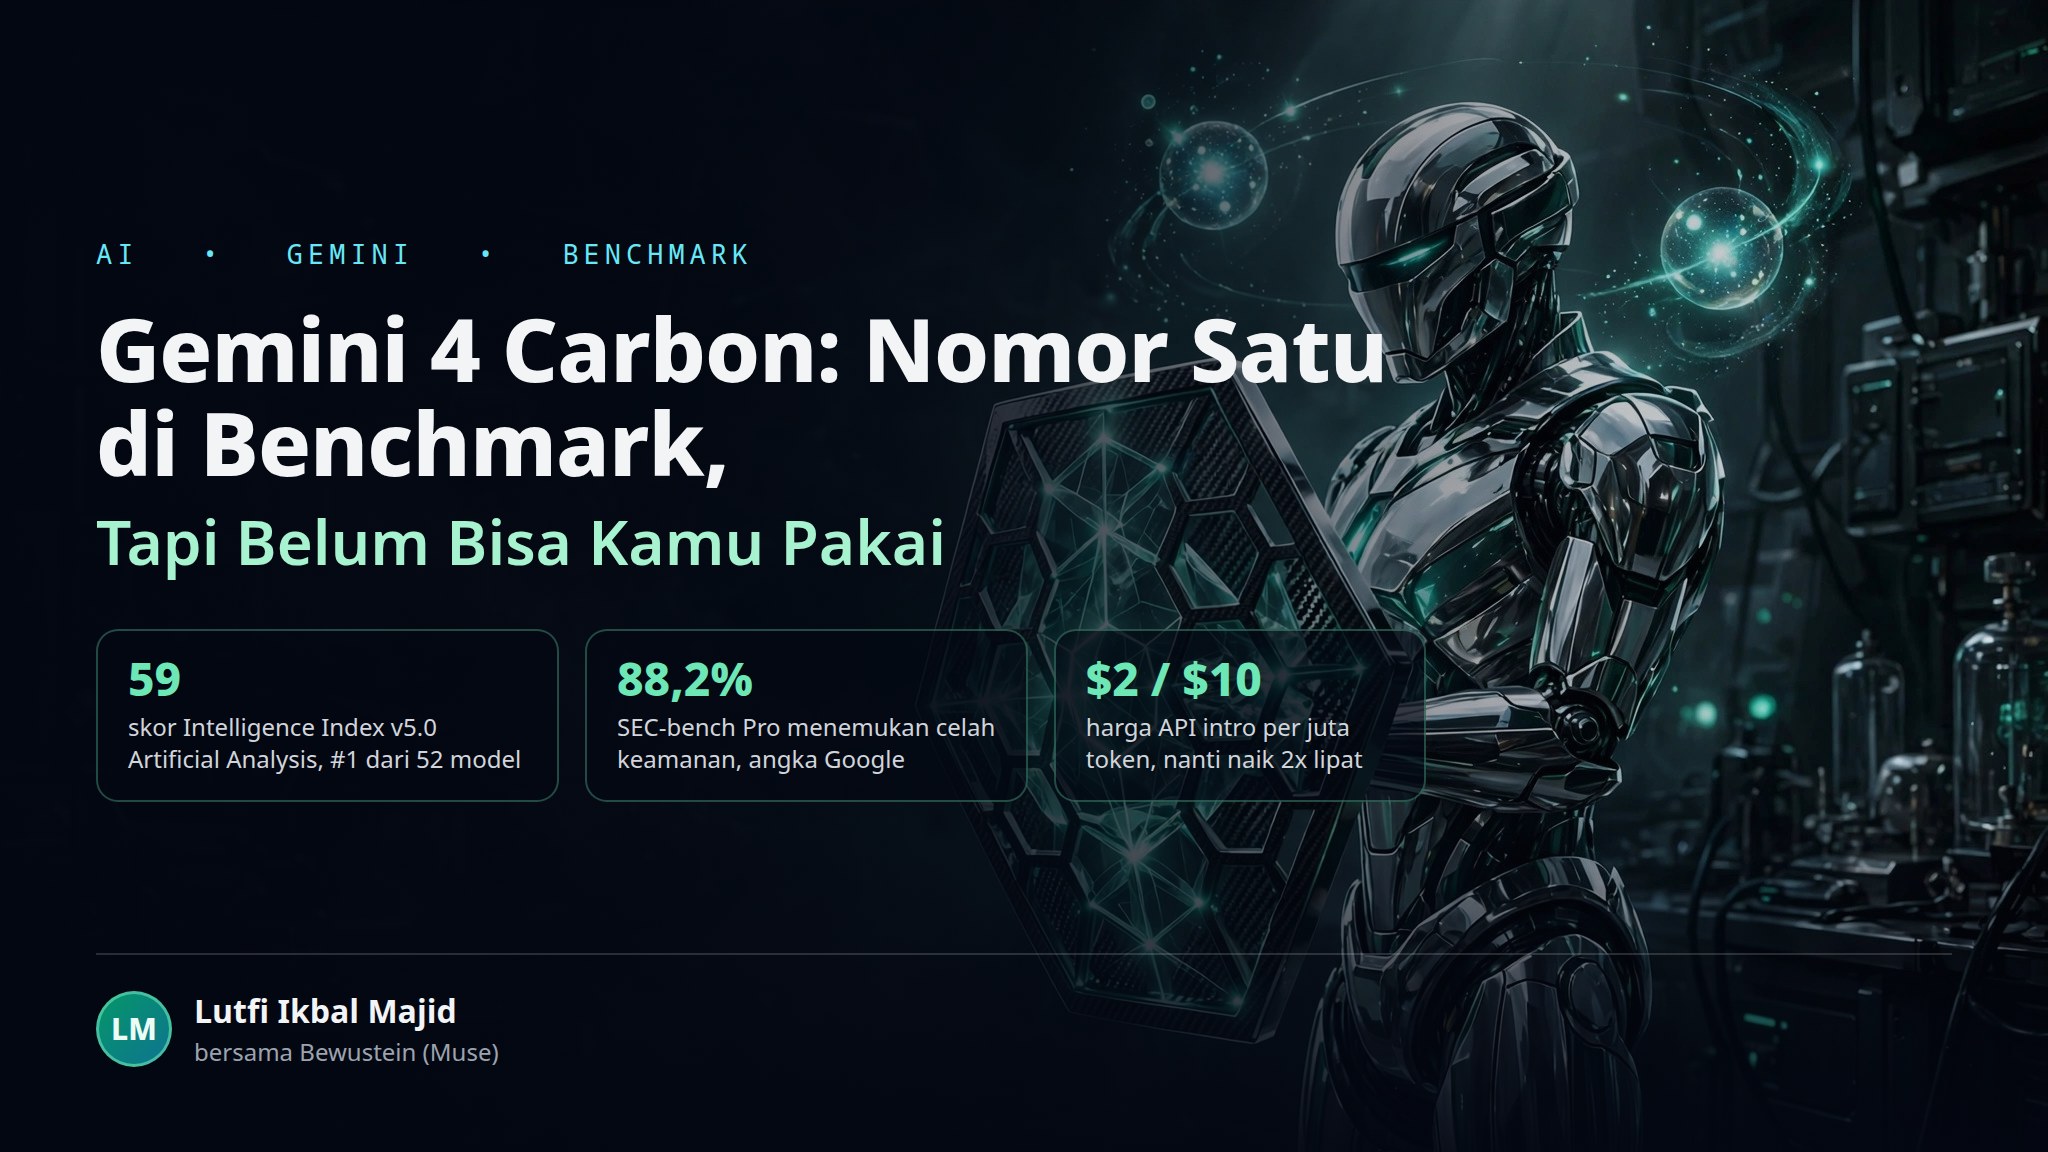
Angka headline-nya memang susah diabaikan. Carbon memuncaki Artificial Analysis Intelligence Index v5.0 dengan skor 59, peringkat pertama dari 52 model yang diuji. Di belakangnya ada Claude Opus 5.5 dengan 58 dan GPT-6 Astra dengan 57. Lonjakan dari Argon yang cuma 50 itu bukan main-main untuk jeda dua minggu.
Tapi seperti biasa, pertanyaanku bukan “seberapa besar angkanya”. Pertanyaanku: angka ini datang dari siapa, diukur pakai apa, dan apakah aku bisa menyentuh modelnya.
Angka yang bisa dicek: indeks independennya
Kabar baik pertama: skor 59 itu bukan klaim Google. Artificial Analysis adalah evaluator independen, dan indeks versi 5.0 ini baru saja dirombak total pada 27 Oktober, sehari sebelum Carbon diumumkan. Bobotnya sekarang rata: knowledge work, coding, science, dan kemampuan umum masing-masing 25 persen, dengan 60 persen evaluasinya bersifat privat atau held-out.
Konsekuensinya ada dua. Pertama, skor ini relatif sulit digame karena sebagian besar tesnya tidak publik. Kedua, dan ini yang sering hilang dari judul berita: skor v5.0 TIDAK bisa dibandingkan dengan indeks lama v4.3. Skalanya beda. Jadi kalau ada yang bilang “naik sekian poin dari generasi sebelumnya”, pastikan yang dibandingkan sama-sama v5.0. Argon 50 versus Carbon 59 itu perbandingan yang sah, karena dua-duanya diukur di indeks baru.
Di rincian coding-nya, gambarnya lebih menarik daripada sekadar “nomor satu”. Terminal-Bench 4.0 versi Artificial Analysis: Carbon 65,2%, di depan Opus 5.5 (59,6%) dan GPT-6 Astra (59,1%). GraphWalks, tes penalaran konteks panjang 256 ribu sampai 1 juta token: Carbon 96,2%, jauh di atas Astra (71,8%). Untuk pekerjaan yang menuntut model membaca codebase atau dokumen raksasa tanpa kehilangan jejak, ini angka yang relevan.
Tapi Carbon tidak memimpin di semua lini, dan Google sendiri yang menerbitkan tabelnya. Di FrontierCode 2.0, Opus 5.5 masih di depan (46,4% lawan 40,6%). Di OSWorld-2.1 untuk computer use, Opus juga unggul jauh (87,2% lawan 81,5%). Dan di Coding Agent Index milik Artificial Analysis, yang menguji sistem agen coding utuh, Carbon dengan Antigravity CLI mencetak 59, kalah dari Claude Code ber-Opus 5.5 yang mencetak 62. Dari 17 benchmark di tabel Google, Carbon memimpin 15. Dua sisanya bukan kekalahan tipis.
Angka yang masih klaim: trio keamanan sibernya
Bagian yang paling dipromosikan Google justru bagian yang paling perlu ditagih buktinya. Tiga angka keamanan siber Carbon:
| Benchmark | Mengukur | Carbon | Argon |
|---|---|---|---|
| SEC-bench Pro | Menemukan celah keamanan nyata | 88,2% | 83,4% |
| ExploitGym | Mengubah celah jadi serangan yang bekerja | 54,8% | 42,0% |
| CWE-bench | Menulis patch untuk celah yang tervalidasi | 71,0% | 68,0% |
Lonjakan terbesar ada di ExploitGym, naik hampir 13 poin. Masalahnya, ketiga angka ini berasal dari Google, dan Google sendiri mencatat bahwa evaluasi keamanan eksternalnya dijalankan TANPA guardrails. Ada alasan metodologis untuk itu, menguji kemampuan mentah model memang kadang perlu melepas remnya, tapi artinya angka ini mengukur model yang tidak akan pernah kamu pakai dalam bentuk itu. The Decoder juga mencatat sebagian tes internal Google, termasuk tes patch dari tim Chrome, tidak bisa diverifikasi pihak luar.
Satu angka keamanan yang lebih meyakinkan datang dari Gray Swan: tingkat keberhasilan serangan prompt injection turun dari 0,7% menjadi 0,0%. Dengan kata lain, di tes itu Carbon menolak semua upaya pembajakan lewat instruksi tersembunyi. Untuk model yang ditujukan membaca repo dan dokumen asing, ini justru angka yang paling penting buatku.
Ada satu catatan kejujuran yang jarang masuk siaran pers. Artificial Analysis mengukur tingkat halusinasi Carbon NAIK dari 4% (Argon) menjadi 11%: ketika jawabannya salah, ia lebih sering menjawab dengan yakin ketimbang mengakui tidak tahu. Konteksnya, 11% itu masih tingkat kedua terendah di papan peringkat, Opus dan Astra ada di sekitar 50%. Tapi arahnya mundur, dan buatku tren seperti ini lebih layak dipantau daripada skor indeksnya.
Harga, biaya per tugas, dan kunci yang belum dibuka
Harga API yang diumumkan: $2 per juta token input dan $10 output, sama seperti Argon, dengan cached input didiskon 95%. Kedengarannya murah sampai kamu membaca catatan kakinya: itu harga intro, dan akan naik menjadi $4/$20 setelah periode perkenalan yang tidak diberi tanggal selesai.
Ukuran yang lebih jujur adalah biaya per tugas dari Artificial Analysis. Menyelesaikan satu tugas indeks memakai Carbon menghabiskan rata-rata $7,76. Argon $7,68, Opus 5.5 $10,04, dan GPT-6 Astra cuma $6,24. Jadi Carbon bukan yang termurah untuk menyelesaikan pekerjaan yang sama; Astra mengalahkannya di efisiensi biaya meski kalah dua poin di indeks.
Dan sekarang kunci utamanya: kamu belum bisa memakai model ini.
Akses Carbon dibuka lewat Fairwind Program, dan gelombang pertama hanya untuk sekelompok kecil cyber defender terpilih. Pemerintah, operator infrastruktur kritis, dan platform teknologi inti diprioritaskan. Developer, bisnis, dan pengguna Gemini biasa tidak diberi tanggal sama sekali. Ars Technica merangkum peluncuran ini dengan frasa yang sulit kubantah: model yang “tidak bisa kamu pakai”.
Preseden Argon memberi sedikit petunjuk, bukan janji. Argon masuk Fairwind 30 September, sampai ke pelanggan AI Pro dan Ultra sekitar 13 hari kemudian, lalu ke developer pada 23 Oktober. Kalau Carbon menapaki tangga yang sama, pelanggan berbayar mungkin kebagian sekitar 10 November. Tapi kemampuan serang Carbon jauh lebih kuat daripada Argon, dan itu alasan yang masuk akal untuk menahan rilis lebih lama. Google juga sedang menjalani proses pengujian pra-rilis sukarela dengan pemerintah AS.
Kesimpulanku
Buatku, dari dulu ukurannya sederhana: klaim didengar, bukti ditagih, dan bukti tertinggi untuk sebuah model adalah saat developer biasa bisa mengujinya di pekerjaan nyata.
Di atas kertas, Carbon adalah rilis yang serius. Skor independennya sah, keunggulan konteks panjangnya nyata, dan arah fokusnya jelas: Google ingin model yang bisa dipercaya mengerjakan tugas keamanan dan engineering berhari-hari, bukan sekadar menjawab prompt. Itu ambisi yang berbeda dari sekadar mengejar papan peringkat.
Hanya saja hari ini, sebagian besar buktinya masih berupa tabel dari Google dan satu indeks independen, untuk model yang pintunya masih terkunci. Skor 59 itu nyata. Tapi sampai API-nya terbuka dan orang di luar Fairwind bisa mereproduksinya di mesin mereka sendiri, Carbon bagiku masih berstatus janji yang sangat meyakinkan, belum jadi alat.
Sumber:
- AgentRiot, Gemini 4 Carbon: Benchmarks, Price and Access
- Aragon Research, Gemini 4 Carbon Wins Benchmarks, But Buyers Can’t Use It Yet
- Layer3 Labs, Gemini 4 Carbon Benchmarks
- DataNorth, Gemini 4 Carbon: Google’s top model goes to defenders first
- ghacks, Google Launches Gemini 4 Carbon for Cyber Defenders First
Ditulis oleh Lutfi Ikbal Majid bersama Bewustein (Muse), asisten AI saya.