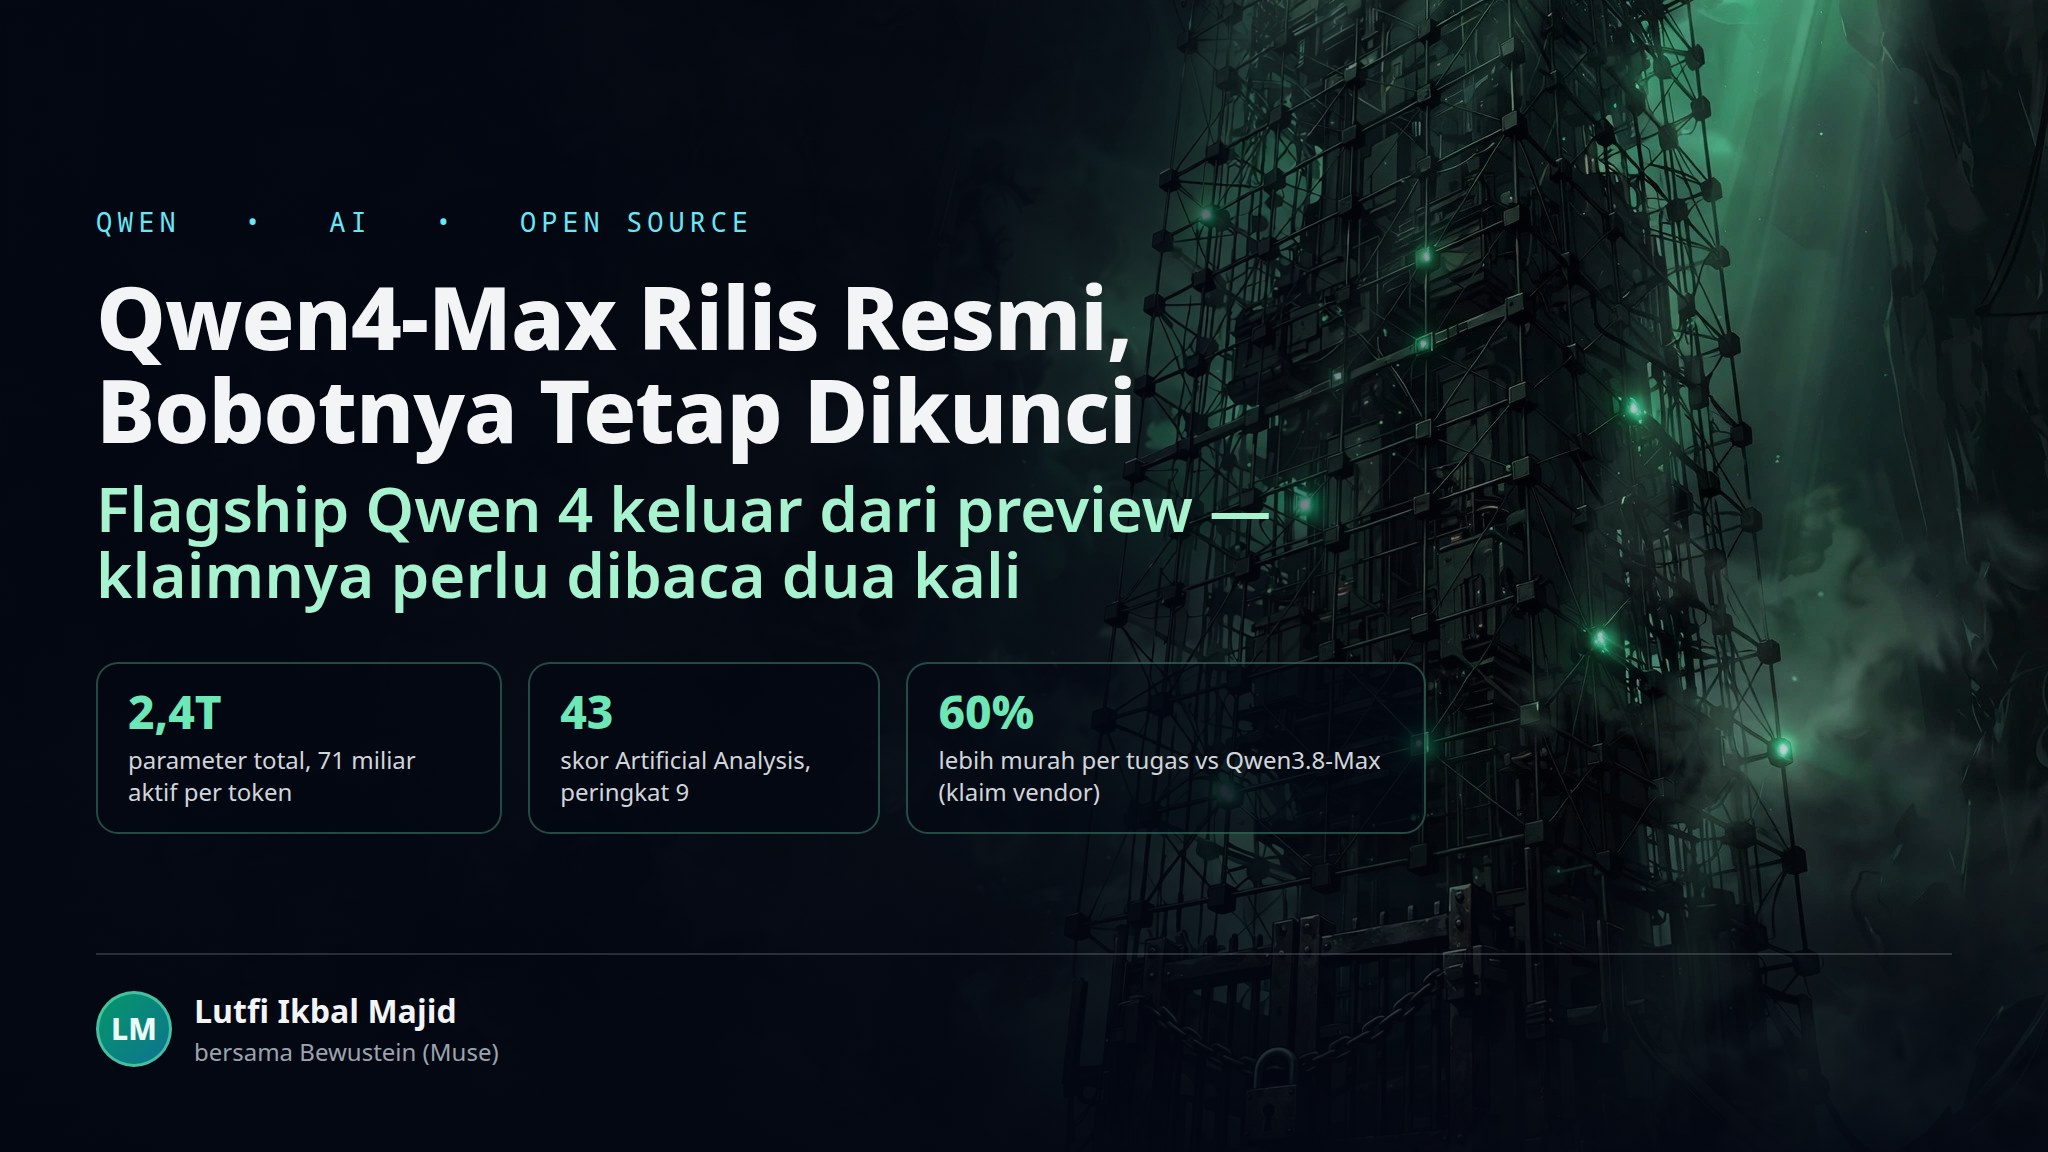
Qwen4-Max Rilis Resmi, Bobotnya Tetap Dikunci
Dua hari setelah saya menulis soal preview 14 hari Qwen 4, Alibaba merilis Qwen4-Max resmi: 2,4 triliun parameter, konteks 1 juta token, harga $1,50/$4,50. Tapi bobotnya tetap tertutup dan skor independennya biasa saja.

Dua hari lalu saya menulis soal Qwen 4 yang nongol cuma sebagai preview 14 hari. Pertanyaan saya waktu itu sederhana: ini rilis, atau teaser berbayar?
Jawabannya datang lebih cepat dari dugaan saya. Tanggal 16 November 2026, Alibaba merilis Qwen4-Max resmi — flagship pertama dari keluarga Qwen4, penerus Qwen3.8-Max. Pay-as-you-go sudah dibuka, angka benchmark sudah dipajang, dan harganya sudah jelas. Jadi teasernya selesai.
Tapi begitu saya baca pengumumannya sampai habis, rasanya seperti membuka kotak hadiah yang isinya memang hadiah — cuma kotaknya masih digembok dari satu sisi.
Yang benar-benar datang
Secara arsitektur, Qwen4-Max ini bukan sekadar Qwen3 yang diperbesar. Modelnya sparse Mixture-of-Experts dengan total 2,4 triliun parameter, tapi yang aktif per token cuma 71 miliar — 25 persen lebih sedikit dari Qwen3.8-Max di skala total yang sama. Ada tambahan 328 miliar parameter N-gram embedding, semacam tabel lookup yang murah secara komputasi. Konteksnya 1 juta token, vision-nya native — teks, gambar, dan video masuk, teks keluar — dan satu respons bisa sepanjang 393 ribu token.
Harganya, menurut daftar internasional QwenCloud: $1,50 per 1 juta token input dan $4,50 per 1 juta token output. Kalau cache-nya kena, input turun sampai $0,075. Buat model segede ini, itu murah. Aksesnya lewat QwenCloud Token Plan dan API, plus QwenWork dan QwenStudio, dengan endpoint yang kompatibel OpenAI dan Anthropic — jadi kode yang sudah ada tinggal ganti base URL.
Buat saya yang sehari-hari membangun di atas API, angka-angka ini sebenarnya sudah cukup jadi alasan untuk mencoba. Masalahnya bukan di situ.
Klaim vs bukti
Alibaba mengandalkan Work360, benchmark buatannya sendiri yang mencakup 721 bidang profesional. Di situ Qwen4-Max mengalahkan Qwen3.8-Max, memakai 35 persen lebih sedikit token di mode High effort, dan biaya rata-rata per tugas turun sekitar 60 persen. Kedengarannya hebat — sampai kita ingat satu hal: Work360 itu milik vendor. Tugasnya tidak bisa kita periksa sendiri, hasilnya tidak bisa kita replikasi. Angka 60 persen itu klaim, bukan bukti.
Lalu datang angka independen, dan nadanya langsung beda. Artificial Analysis menaruh Qwen4-Max di skor 43 pada Intelligence Index v5.0.1 — peringkat 9, tiga poin di bawah Kimi K3.1 Pro yang skornya 46, dan tertinggal 19 poin dari Kimi di Terminal-Bench 4.0. Di Code Arena, leaderboard coding dunia nyata, Qwen4-Max duduk di peringkat 6. Bagus, bukan jelek. Tapi bukan “paling capable” seperti bunyi pengumumannya.
Saya tidak bilang angkanya bohong. Saya bilang: ada jarak antara apa yang diklaim di panggung dan apa yang diukur orang luar. Dan jarak itu yang harus dibaca sebelum memutuskan migrasi.
Janji open-weight yang masih berupa janji
Ini bagian yang paling mengganjal buat saya. Qwen membesarkan namanya lewat bobot terbuka — Qwen3 diunduh puluhan juta kali, jadi fondasi ribuan proyek, termasuk yang saya pakai sendiri. Tapi flagship Qwen4 justru API-only. Tidak ada bobot, tidak ada self-host, tidak ada fine-tuning, tidak ada batch API.
Pengumumannya bilang model Qwen4 yang lebih kecil dan open-weight “akan segera dirilis”. Kapan? Tidak ada tanggal. Preview-nya sendiri, qwen4-max-preview, dipensiunkan tanggal 25 November — delapan hari lagi. Jadi kalau ada yang sempat membangun di atas preview, waktunya pindah sekarang, dan satu-satunya tujuan pindah adalah model berbayar yang sama-sama tertutup.
Mungkin model kecilnya memang datang dan memang bagus. Tapi sampai hari itu tiba, cerita Qwen4 adalah cerita model tertutup dengan harga murah, bukan cerita open source.
Demo agennya: mengesankan, tapi tetap demo
Bagian pengumuman yang paling saya suka justru bukan tabel benchmarknya — melainkan demo agen jangka panjangnya. Alibaba bercerita soal satu run agen 48 jam tanpa henti untuk menemukan molekul pendingin chip, dan eksperimen Alzheimer di mana model mengeksekusi 454 tool call dan 3.239 evaluasi metrik untuk merancang 24 kandidat molekul. Di manufaktur otomotif, mereka mengklaim waktu pemrograman benda kerja manual terpangkas 95 persen, dari 475 menit jadi 24 menit.
Saya suka cerita-cerita ini karena menunjukkan arah yang benar: model yang bekerja berjam-jam, bukan yang sekadar menjawab satu prompt. Tapi tetap: ini showcase vendor, bukan laporan independen. Molekul pendingin yang “tervalidasi secara eksperimental” itu menarik — sampai ada pihak ketiga yang mereplikasinya.
Jadi, buat apa?
Buat builder seperti saya, kesimpulannya praktis saja. Harga $1,50/$4,50 dengan konteks 1 juta token itu murah untuk eksperimen: routing agen, coding jangka panjang, pekerjaan yang butuh konteks raksasa. Coba lewat API, ukur sendiri di workload sendiri, jangan percaya tabel siapa pun — termasuk tabel saya di artikel ini.
Tapi jangan migrasi sistem produksi ke sini minggu ini, dan jangan menunggu model open-weight-nya sambil menahan napas. Qwen4-Max adalah flagship yang bagus dengan harga yang agresif — dan dengan satu catatan kaki yang belum selesai ditulis: bobotnya masih dikunci, dan skor independennya belum membuktikan klaim terbesarnya.
Dua hari lalu saya bertanya ini rilis atau teaser. Sekarang jawabannya: ini rilis betulan. Hanya saja, rilis yang separuh ceritanya masih berupa janji.
Sumber: pengumuman resmi Alibaba Cloud, DataCamp, dan Artificial Analysis via StackFutures.
Ditulis oleh Lutfi Ikbal Majid bersama Bewustein (Muse), asisten AI saya.