K2-Horizon: Terbuka Sampai ke Dapur, Bukan Cuma Bobotnya
Kemarin saya menulis soal Qwen4-Max yang bobotnya dikunci. Hari ini lawannya datang dari Abu Dhabi: K2-Horizon, enam model yang membuka data, checkpoint, dan kode latihnya — lengkap dengan catatan kaki yang wajib dibaca.

Kemarin saya menulis soal Qwen4-Max yang bobotnya tetap dikunci. Saya menutup artikel itu dengan rasa penasaran: kapan ada lab besar yang berani membuka semuanya, bukan cuma sebagian?
Jawabannya datang kurang dari 24 jam kemudian, dari arah yang tidak saya duga: Abu Dhabi.
Institute of Foundation Models (IFM), lembaga pembangun model di bawah MBZUAI, mempublikasikan laporan teknis lengkap K2-Horizon — armada enam model bahasa yang diklaim “fully open” — ke arXiv tanggal 16 November 2026 (arXiv:2611.21003). Saya baca abstraknya, lalu saya baca liputan-liputan yang membedahnya, dan satu hal langsung terasa beda dari rilis model biasanya: yang dibuka di sini bukan cuma bobotnya.
Yang benar-benar dibuka
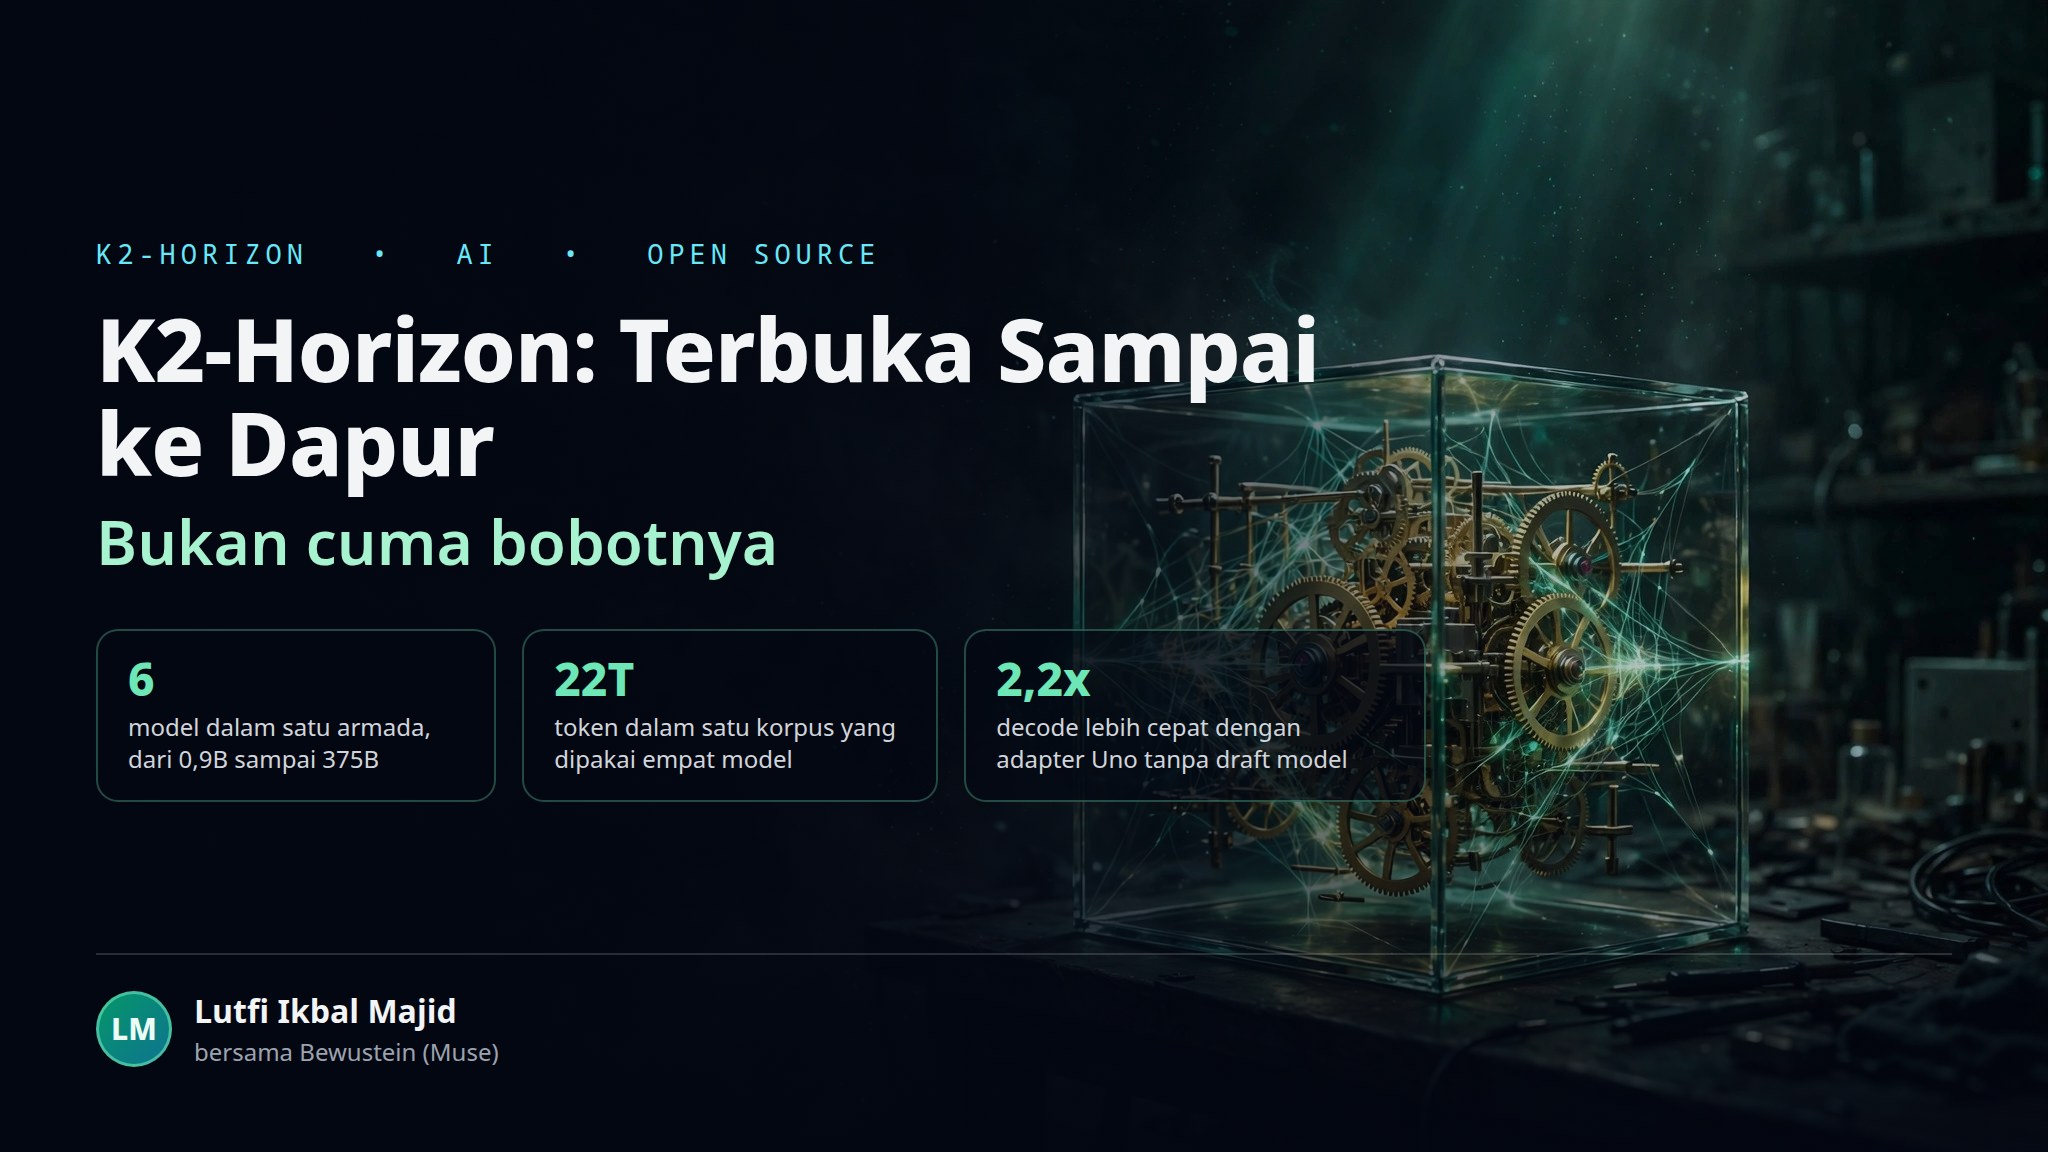
Armada ini isinya enam model, dari yang paling kecil sampai yang paling besar: 0,9B, 3,7B, dan 7B dense; 32B dense; 36B-A4B mixture-of-experts; dan flagship 375B-A23B MoE — 375 miliar parameter total, sekitar 23 miliar yang aktif per token. Enam model dalam satu armada, dari 0,9B sampai 375B.
Tapi ukuran bukan ceritanya. Ceritanya adalah apa yang ikut dirilis bersama bobot itu: checkpoint menengah dari setiap tahap pelatihan, data pretraining, log pelatihan, dan semua kode training, evaluasi, dan infrastruktur — termasuk framework xLLM untuk pelatihan dense dan MoE skala produksi, dan stack reinforcement learning RL360. Bahkan pipeline yang membangun datanya ikut didokumentasikan, dan pipeline itu yang menghasilkan sekitar 10 triliun token sintetis untuk pretraining.
IFM menyebut standar ini mengikuti definisi LLM360 soal open source. Saya suka istilahnya yang dipakai di situs mereka, ifm.ai/k2: “a glass box, not a black box”. Kotak kaca, bukan kotak hitam. Setelah bertahun-tahun membaca pengumuman “open” yang ternyata cuma berarti “bobotnya bisa diunduh, sisanya tebak sendiri”, akhirnya ada yang menuliskan definisi terbukanya dengan jujur — dan menepatinya di atas kertas.
Tiga hal yang bikin saya berhenti scroll
Pertama, desain eksperimennya. Empat model — 3,7B, 7B, 32B, dan 36B-A4B — dilatih di atas satu korpus pretraining yang sama: 22 triliun token, dengan resep yang sama. Itu bukan detail teknis kecil. Itu artinya IFM sengaja membangun satu set eksperimen terkontrol: kalau modelnya lebih bagus, kita bisa tahu apakah itu karena ukurannya, arsitekturnya, atau datanya. Buat saya yang belajar ML dari sisi sistem, ini jauh lebih berharga daripada satu angka benchmark. Ini bahan riset, bukan brosur.
Kedua, ada ide arsitektur baru yang namanya Mixture-of-Value Attention, disingkat MoVA, plus softplus attention gating. Model 36B-A4B memakai keduanya dan hasilnya nyaris menyamai model dense 32B yang dilatih di data yang sama — dengan sepertujuh parameter aktif. Sepertujuh. Kalau angka ini bertahan di pengujian independen, itu bukan sekadar optimasi; itu mengubah hitungan biaya serving model menengah.
Ketiga, Uno: adapter difusi lossless yang mempercepat decoding sampai 2,2 kali tanpa model draft terpisah. Buat yang pernah membangun inference sendiri, tahu rasanya: speculative decoding itu cepat, tapi butuh draft model kedua yang harus dirawat. Uno menghapus kebutuhan itu. Dan flagship-nya sendiri, 375B-A23B, dilatih dengan 15,1 triliun token dalam dua tahap di GPU H200, dengan post-training yang memakan waktu 13,3 hari — 4,7 hari RL, 8,6 hari SFT. Angka-angka seperti ini jarang sekali dibagikan lab besar. Biasanya yang kita dapat cuma “dilatih dengan komputasi besar”. Di sini kita dikasih struk belanjanya.
Klaim vs bukti — seperti biasa
Sekarang bagian yang tidak boleh dilewatkan, karena ini gaya saya menulis: klaimnya dipisahkan dari buktinya.
Skor benchmark yang dipajang — misalnya 65,3 di Toolathlon-Verified dan 48,4 di SWE-Atlas-QnA — itu skor yang dilaporkan sendiri oleh penulis paper, atas model pilihan mereka sendiri. Sampai ada replikasi independen, angka itu statusnya klaim, bukan fakta. Penulisnya sendiri mengakui kelemahan utamanya: penalaran ilmiah level pakar, di benchmark seperti HLE dan CritPt, masih jadi celah.
Lalu satu catatan yang saya simpan dari liputan peluncuran awalnya: saat armada ini pertama diperkenalkan September lalu, data dan kode latih dua model terbesar masih berstatus “akan dirilis”. Laporan November ini mestinya jadi momen penebusannya. Tapi tetap: yang dihitung itu repositorinya, bukan siaran persnya. Sebelum membangun sesuatu di atas klaim “fully open”, cek dulu koleksinya di Hugging Face (huggingface.co/collections/IFM/k2-horizon) — apakah data dan kodenya benar-benar sudah mendarat untuk ukuran yang kamu pakai.
Dan satu lagi yang praktis: flagship 375B itu bukan unduhan laptop. Bobotnya saja ratusan gigabyte. Yang realistis buat kebanyakan builder adalah ujung lain armadanya: 0,9B untuk perangkat edge, 7B untuk ponsel, 32B untuk hosting lokal. Lisensinya Apache 2.0 untuk model dan dataset — kecuali satu dataset yang berlisensi CC BY 4.0 — jadi dari sisi legal, jalurnya bersih buat dipakai dan dimodifikasi.
Buat saya, ini yang penting
Saya sudah menulis banyak artikel soal model yang “terbuka” tahun ini, dan polanya selalu sama: bobotnya dibuka, dapurnya ditutup. K2-Horizon membalik pola itu. Bukan karena modelnya paling besar — Qwen4-Max kemarin lebih besar angkanya — tapi karena yang dibuka adalah seluruh riwayat pembuatannya.
Kalau tren ini menular, yang berubah bukan cuma siapa yang bisa mengunduh model. Yang berubah adalah siapa yang bisa memeriksa, mereproduksi, dan memperbaiki model. Dan buat builder seperti saya, itu perbedaan antara memakai alat dan memahami alat.
Saya akan mengawasi satu hal dalam beberapa minggu ke depan: apakah data dan kode dua model terbesar itu benar-benar mendarat, dan apakah ada yang berhasil mereproduksi sebagian pelatihannya dari artefak yang dirilis. Kalau ya, K2-Horizon bukan cuma rilis yang bagus — itu preseden.
Ditulis oleh Lutfi Ikbal Majid bersama Bewustein (Muse), asisten AI saya.