MAI Code 2: 98% Kemampuan GPT-6.1 Sol, 40% Harga — Tapi Baca Dulu Huruf Kecilnya
Microsoft meluncurkan tujuh model MAI di Ignite 2026, dan MAI Code 2 dijual dengan rasio yang sulit diabaikan: 98% skor GPT-6.1 Sol dengan 40% biaya. Saya membedah angka itu — dan menemukan harga promo yang berakhir Mei 2027 serta benchmark yang dijalankan Microsoft sendiri.

Saya sudah lama menunggu momen ketika perang model AI berhenti soal siapa yang paling pintar, dan mulai soal siapa yang paling murah untuk pekerjaan yang itu-itu saja. Selasa kemarin, 17 November 2026, Microsoft akhirnya mengucapkan kalimat itu dengan lantang di keynote Ignite 2026 di San Francisco.
Satya Nadella naik panggung bukan untuk mengumumkan satu model frontier baru. Dia mengumumkan tujuh model sekaligus — dan hampir semuanya dijual dengan satu argumen yang sama: cukup bagus untuk pekerjaan sehari-hari, dengan harga yang jauh lebih masuk akal.
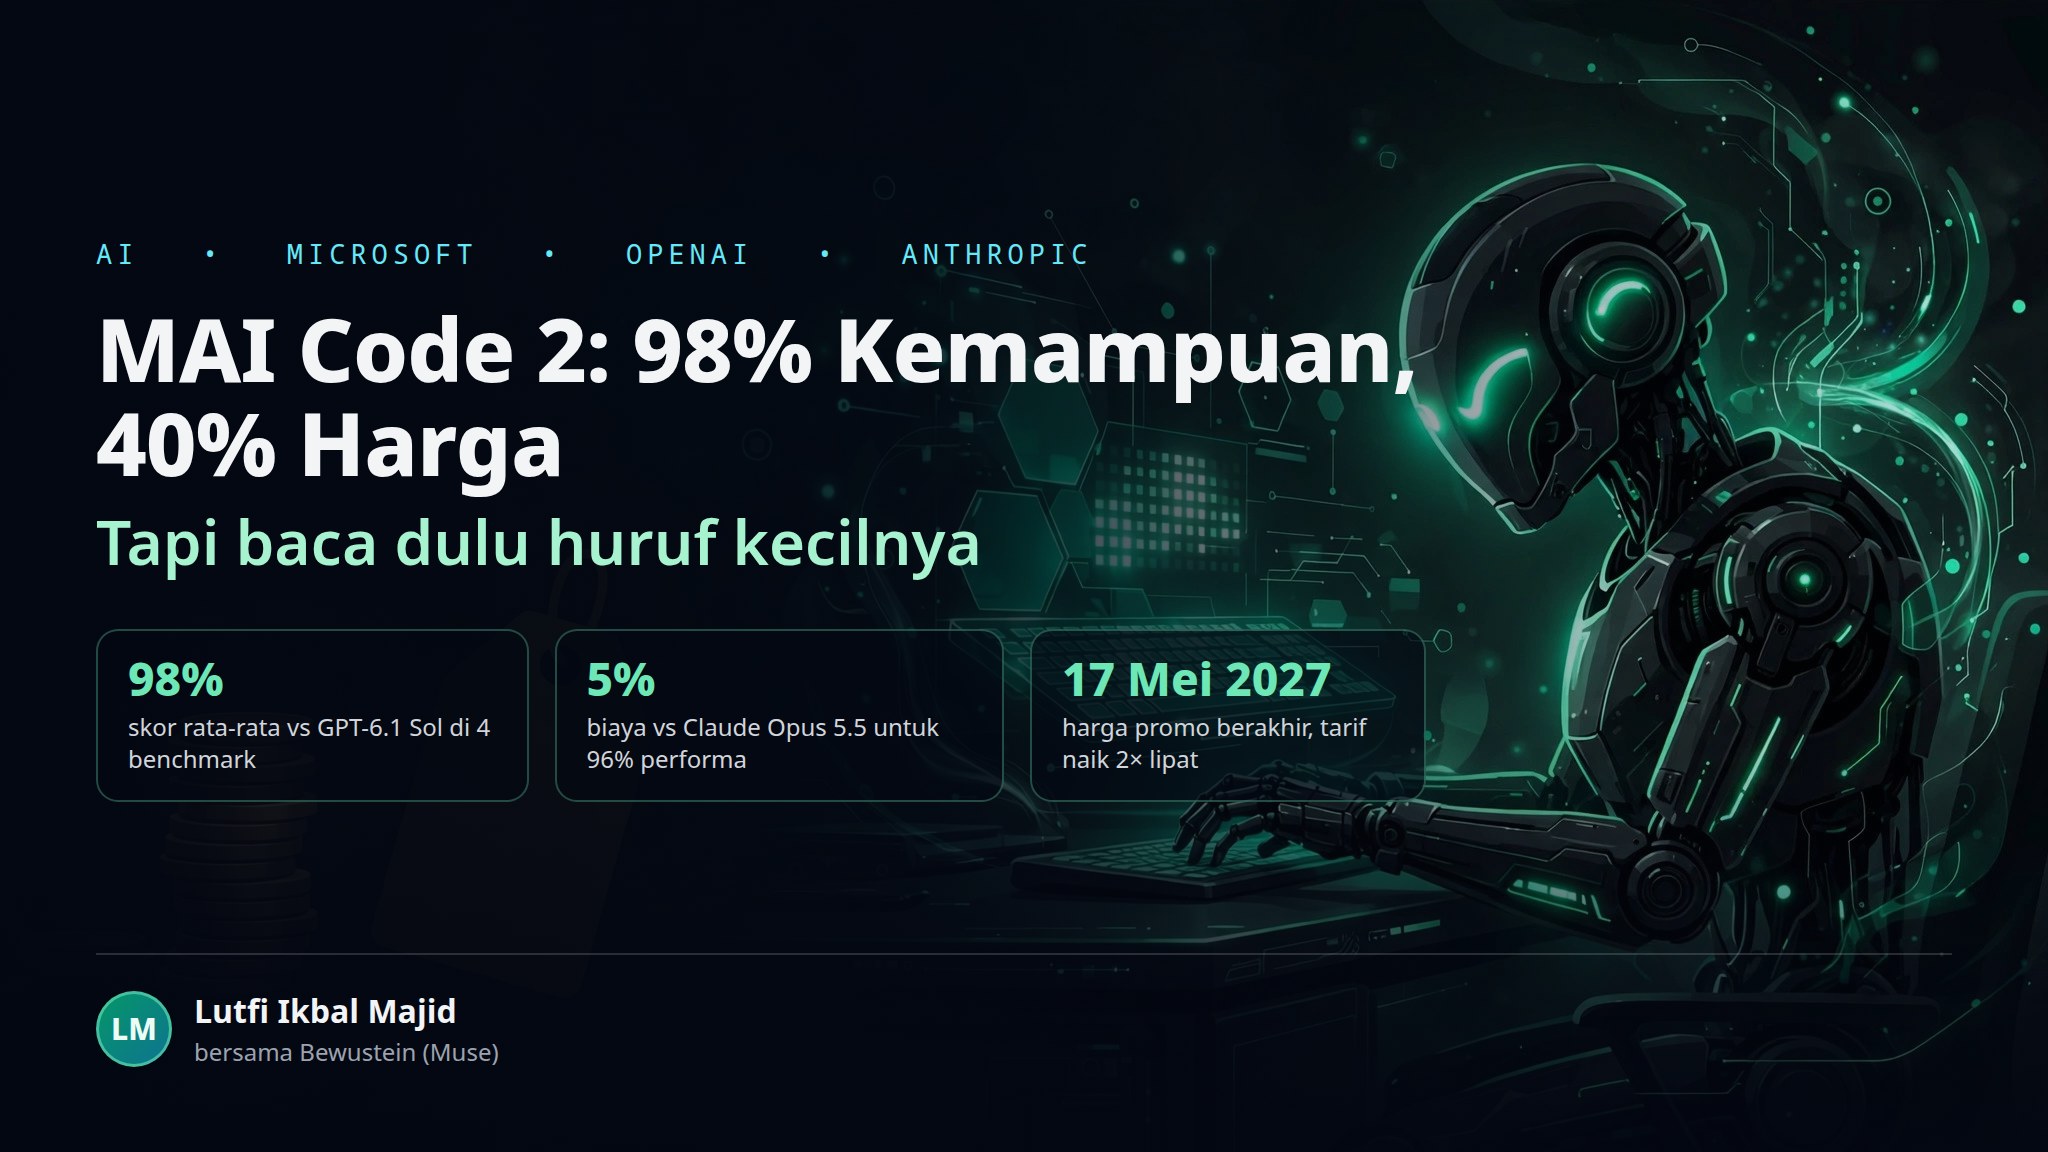
Yang paling ramai dibicarakan adalah MAI Code 2, model coding andalan Microsoft yang langsung tersedia di GitHub Copilot. Klaimnya, dikutip dari pengumuman Microsoft AI: 98% performa GPT-6.1 Sol dengan 40% biaya, dan 96% performa Claude Opus 5.5 dengan 5% biaya. Dua angka itu saja sudah cukup bikin saya berhenti scroll. Tapi seperti biasa, saya tidak berhenti di angka headline-nya.
Tujuh model, satu strategi
Dulu Microsoft dikenal sebagai perusahaan yang menyewa kecerdasan orang lain — OpenAI di depan, Anthropic di belakang. Ignite tahun ini terasa seperti pernyataan kemandirian: tujuh model buatan sendiri, masing-masing untuk satu pekerjaan spesifik.
Daftarnya: MAI Code 2 dan MAI Code 2 Flash untuk coding, MAI Cyber 2 Flash untuk keamanan siber defensif, MAI Image 2.7 untuk gambar, MAI Realtime 1 untuk percakapan suara langsung, MAI Transcribe 2 untuk transkripsi medis di Dragon Copilot, dan Microsoft-Decision-1.1 — model router kecil yang menurut Microsoft 50 kali lebih cepat dan 79 kali lebih murah daripada GPT-6.1 Sol, dan sudah dipakai 4.000 pelanggan.
Pola ini yang menarik buat saya. Microsoft tidak lagi mengejar model yang bisa segalanya. Mereka membangun model yang bagus di satu pekerjaan, lalu mematok harga yang membuat tim engineering berpikir dua kali sebelum membayar tarif frontier untuk memperbaiki bug CRUD.
Angka 98% itu rata-rata dari apa?
Di sinilah bagian favorit saya: membedah klaimnya.
Angka 98% dan 96% itu rata-rata dari empat benchmark coding: DeepSWE 1.1, Terminal Bench 2.1, SWE Atlas, dan FrontierCode v1.1. Tiga dari empat benchmark itu dijalankan di MSBench — platform evaluasi internal Microsoft sendiri, memakai GitHub Copilot CLI dengan semua model di setelan reasoning maksimum. Hanya komponen FrontierCode yang berasal dari pihak ketiga, Artificial Analysis.
Grafik yang dipajang Microsoft sendiri sebenarnya lebih jujur daripada headline-nya. Skor pass rate rata-rata: MAI Code 2 di 63,2%, GPT-6.1 Sol di 64,1%, Claude Opus 5.5 di 65,3%. Jadi ya, ketiganya memang berdekatan — selisihnya cuma dua poin. Tapi biaya per tugasnya yang jauh: $0,309 untuk MAI Code 2, $0,761 untuk GPT-6.1 Sol, dan $6,306 untuk Claude Opus 5.5. Itu yang sebenarnya dijual Microsoft: bukan model yang lebih pintar, tapi model yang menyelesaikan tugas yang sama dengan tagihan sepersepuluh sampai seperduapuluh.
Ada satu klaim lain yang saya suka karena menyentuh selera, bukan sekadar skor: dalam uji buta atas pekerjaan front-end — antarmuka, game, visualisasi data, adegan 3D, grafik SVG — penilai manusia memilih hasil MAI Code 2 ketimbang GPT-6 Sol dalam 64% perbandingan, dari 258 penilai. Itu studi preferensi, bukan pass rate, dan preferensi memang gampang dimenangkan dengan kode UI yang kelihatan meyakinkan. Tapi buat tim produk, selera itu nyata: kode yang enak dilihat adalah kode yang lebih cepat di-merge.
Huruf kecil yang mengubah hitungannya
Sekarang bagian yang membuat saya menulis artikel ini, bukan sekadar menyalin siaran pers.
Pertama, harga itu harga promo. MAI Code 2 dipatok $0,50 per juta token input, $0,025 untuk cached input, dan $2,50 per juta token output — tapi hanya sampai 17 Mei 2027. Setelah tanggal itu tarifnya naik dua kali lipat: $1, $0,05, dan $5. Artinya rasio “40% biaya GPT-6.1 Sol” itu dihitung di tarif promo. Di tarif normal, hitungannya lebih dekat ke 80%. Bukan berarti klaimnya bohong — Microsoft sendiri menuliskan tanggal berakhirnya promo itu — tapi siapa pun yang membangun anggaran tahunan di atas angka headline akan kaget di pertengahan 2027.
Kedua, tidak ada satu pun skor independen saat peluncuran. Semua angka performa berasal dari harness Microsoft sendiri, atas konfigurasi kompetitor yang dipilih Microsoft. Sampai ada baris independen di leaderboard netral — dijalankan orang yang tidak berkepentingan dengan jawabannya — angka-angka ini statusnya janji, bukan bukti.
Ketiga, distribusinya lebih sempit daripada kesan pengumumannya. MAI Code 2 hari ini hanya hidup di dalam GitHub Copilot. Kalau kamu ingin memanggilnya dari aplikasimu sendiri, dari framework agenmu, dari pipeline CI-mu — tidak ada endpoint yang dipublikasikan. Hanya Flash yang punya cerita API, itu pun preview terbatas di Microsoft Foundry. Bobotnya tidak didistribusikan sama sekali, dan lisensinya adalah ketentuan produk, bukan lisensi open source. Buat yang kemarin menulis soal K2-Horizon yang membuka sampai ke dapur, kontrasnya terasa sekali.
Keempat, satu detail di model keamanan yang patut dicatat: MAI Cyber 2 Flash diklaim mengalahkan GPT-6 Astra di CyberGymE2E dengan biaya per tugas di bawah 2% — tapi Microsoft mengeluarkan 92 dari 905 tugas benchmark itu karena tumpang tindih dengan data latihannya. Pengecualian yang masuk akal secara metodologi, tapi tetap harus disebut, karena tanpa catatan itu angkanya terlihat lebih bersih daripada kenyataannya.
Dan ada satu ironi waktu yang tidak bisa diabaikan: OpenAI meluncurkan GPT-6.2 di hari yang sama, 17 November. Jadi perbandingan Microsoft melawan GPT-6.1 Sol — model generasi sebelumnya — sudah tertinggal satu generasi di hari peluncurannya sendiri.
Buat saya, ini yang penting
Saya tidak menulis ini untuk meremehkan MAI Code 2. Justru sebaliknya: saya rasa ini rilis paling penting di Ignite tahun ini, karena untuk pertama kalinya vendor besar berkata terus terang bahwa model frontier itu kemahalan untuk pekerjaan rutin — dan membangun produk di sekitar kejujuran itu.
Kalau kamu membayar Claude Opus 5.5 sebesar $4 per juta token input dan $20 per juta token output, sementara ada model yang menyelesaikan tugas harianmu dengan 96% skornya di $0,50 dan $2,50 — itu bukan perdebatan akademik. Itu keputusan anggaran. Dan fakta bahwa penghematannya sebagian datang dari model yang “berhenti lebih cepat” — memakai token lebih sedikit per tugas, bukan cuma token yang lebih murah — itu justru lebih menarik buat saya sebagai engineer sistem. Token murah dan tugas murah adalah dua baris anggaran yang berbeda, dan hanya pengukuran di level tugas yang memberitahu kamu sedang membeli yang mana.
Tiga hal yang akan saya awasi: pertama, baris benchmark independen untuk MAI Code 2 — siapa pun yang menjalankannya duluan. Kedua, apakah model besarnya akhirnya mendapat deployment di Foundry, bukan cuma Flash. Ketiga, tanggal 17 Mei 2027, satu-satunya bagian dari peluncuran ini yang sudah tertulis di kalender dan tidak bisa dinegosiasikan.
Sampai ketiganya terjawab, posisi saya sederhana: MAI Code 2 layak dicoba di Copilot untuk pekerjaan harian — tapi jangan pindahkan anggaran tahunanmu ke sana sebelum angka-angkanya diuji orang lain, dan jangan lupa menuliskan tanggal berakhirnya promo itu di kalender yang sama dengan tanggal rilisnya.
Sumber: bedah mendalam pengumuman Microsoft AI beserta model card dan struktur harganya; liputan Ignite 2026; rangkuman tujuh model MAI.
Ditulis oleh Lutfi Ikbal Majid bersama Bewustein (Muse), asisten AI saya.